2026년, 임베디드 AI 배포 지옥 탈출의 서막
2026년 현재, 임베디드 시스템에 AI를 적용하려는 현직 엔지니어들은 여전히 ‘배포 지옥’에 시달리고 있습니다. 클라우드 기반 AI 모델은 네트워크 지연, 프라이버시 문제, 막대한 대역폭 비용, 그리고 감당하기 어려운 전력 소모라는 근본적인 한계를 안고 있습니다. 반면, 자원이 극도로 제한된 마이크로컨트롤러(MCU) 환경에 대형 AI 모델을 그대로 올리려다 보면 메모리 오버플로우와 처참한 성능 저하라는 벽에 부딪히기 일쑤입니다.
하지만 희망은 있습니다. 바로 TinyML(초소형 머신러닝)입니다. 2025~2026년을 기점으로 본격적인 실용화 단계에 진입한 TinyML은 센서와 초저전력 MCU(예: ARM Cortex-M, 스페셜티 NPU 탑재 칩) 수준에서 밀리초(ms) 단위의 실시간 추론과 서브밀리와트(Sub-mW)급 전력 소모를 달성하는 핵심 기술로 자리 잡았습니다. 이 글은 현직 엔지니어 여러분이 TinyML을 활용하여 임베디드 AI 모델의 성능을 최대 10배 향상시키고 전력 소모를 50% 이상 절감하는 실질적인 방법을 제시합니다.
TinyML, 어떻게 엣지 디바이스의 한계를 뛰어넘는가?
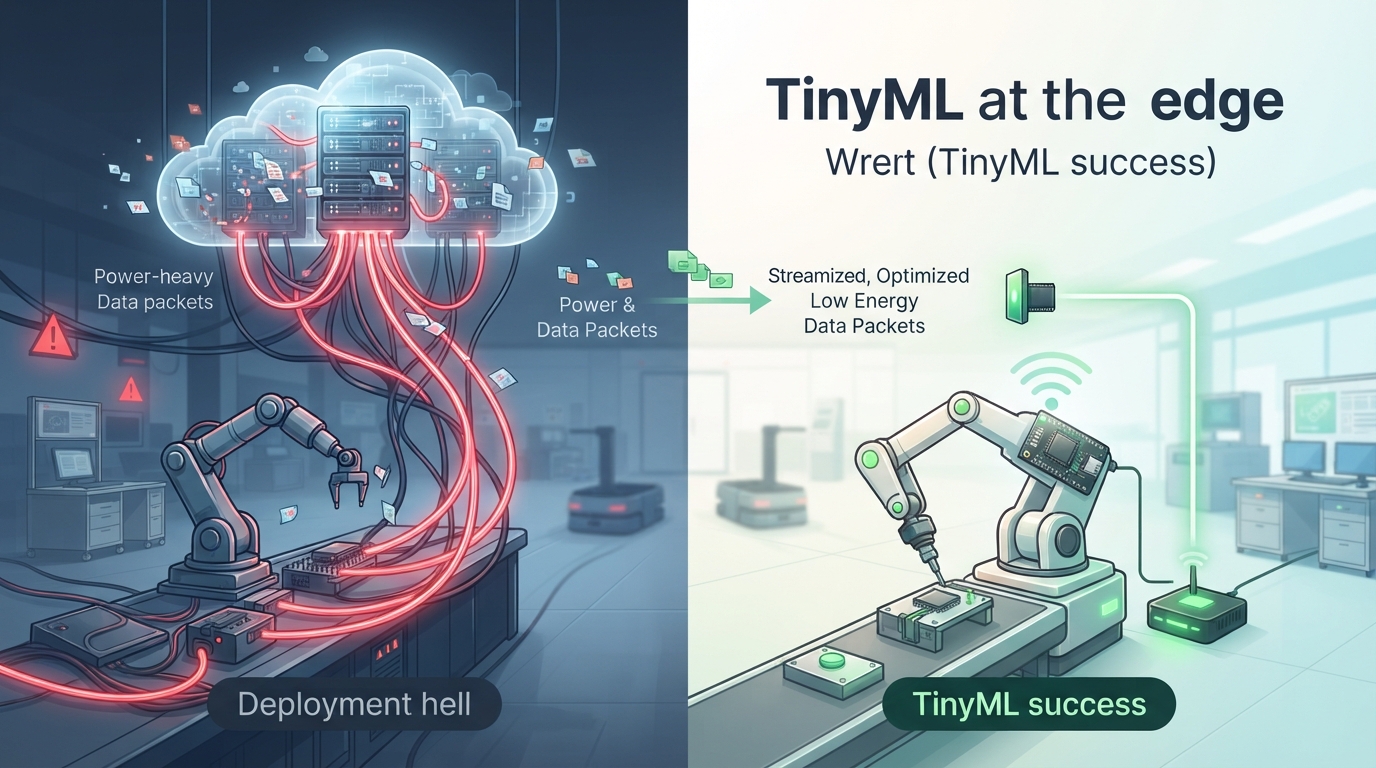
TinyML은 단순히 작은 AI 모델을 의미하는 것을 넘어, 극도로 제한된 하드웨어 자원(수백 KB의 RAM과 수 MB의 Flash)에서 AI 모델을 효율적으로 구동하기 위한 일련의 기술과 방법론을 포괄합니다. 클라우드 AI가 ‘크고 강력한’ 모델에 집중한다면, TinyML은 ‘작고 빠르며 효율적인’ 모델에 초점을 맞춥니다.
성능 10배 향상 및 전력 50% 절감의 핵심 원리
- 양자화(Quantization): 가장 강력한 경량화 기법 중 하나입니다. 32비트 부동소수점(FP32)으로 학습된 모델의 가중치를 8비트 정수(INT8)로 변환하여 메모리 점유율을 4분의 1 이하로 줄입니다. 이는 연산 속도를 크게 높이고, 메모리 접근에 필요한 전력을 대폭 절감합니다. INT8 경량화만으로도 연산 및 메모리 사용량을 4배 이상 줄여 시스템 전력을 크게 낮출 수 있습니다.
- 프루닝(Pruning) 및 모델 증류(Knowledge Distillation): 모델 내에서 중요도가 낮은 가중치나 연결을 제거(프루닝)하여 모델 크기를 줄이고, 대형 모델의 학습된 지식을 소형 모델에 전수(증류)하여 성능 손실을 최소화하면서 모델을 경량화합니다.
- 하드웨어 최적화: ARM Helium과 같은 벡터 확장 명령어 세트나 전용 NPU(신경망 처리 장치)가 탑재된 칩을 활용하여 AI 연산을 하드웨어 레벨에서 가속화합니다. 이는 소프트웨어 최적화만으로는 달성하기 어려운 압도적인 처리 효율과 응답 속도를 제공합니다.
- 불필요한 메모리 액세스 축소 및 온디바이스 전처리: 모델 경량화와 함께 불필요한 메모리 접근을 최소화하고, 센서 데이터를 디바이스 내에서 직접 전처리하여 클라우드 전송 비용과 전력 소모를 제거합니다. 저전력 슬립 모드(Sleep Mode)와의 결합은 배터리 수명을 획기적으로 연장시킵니다.
현직 엔지니어를 위한 TinyML 실전 파이프라인
TinyML 모델을 성공적으로 배포하기 위한 단계별 로드맵은 다음과 같습니다. 클라우드 중심 사고에서 벗어나 초기 설계 단계부터 엣지 제약을 고려하는 것이 중요합니다.
[데이터 수집] ➔ [모델 학습] ➔ [경량화 (양자화·프루닝·증류)] ➔ [컴파일/변환 (TFLite Micro / ExecuTorch)] ➔ [OTA 패키징] ➔ [현장 추론 및 모니터링]1. 데이터 수집 및 모델 학습
- 엣지 제약 고려: 초기 데이터 수집 및 모델 설계 단계부터 대상 디바이스의 RAM/Flash 예산을 염두에 두어야 합니다.
- 경량 모델 구조 선택: 1D CNN, 오토인코더, DS-CNN(Depthwise Separable Convolutional Neural Network), Tiny Transformer 등 임베디드 환경에 최적화된 경량 구조를 선택합니다.
2. 모델 경량화 (Model Compression)
- 양자화: 32비트 부동소수점(FP32) 가중치를 8비트 정수(INT8)로 변환하여 메모리 점유율을 4분의 1 이하로 축소합니다. 학습 후 양자화(Post-training Quantization)와 양자화 인식 학습(Quantization-aware Training)을 적절히 활용하여 정확도 손실을 최소화합니다.
- 프루닝 & 증류: 중요하지 않은 가중치를 제거하고, 대형 모델의 지식을 소형 모델에 전수하여 모델 크기를 더욱 줄입니다.
3. 컴파일 및 프레임워크 변환
- 임베디드 전용 프레임워크 활용:
TensorFlow Lite for Microcontrollers (TFLite Micro)또는PyTorch ExecuTorch와 같은 임베디드 전용 프레임워크를 사용하여 모델을 변환합니다. - 하드웨어 아키텍처 매핑: 타겟 MCU 아키텍처(ARM Cortex-M 시리즈, 하드웨어 NPU 등)에 최적화된 커널 오퍼레이터로 매핑하여 하드웨어 가속을 최대한 활용합니다.
4. 배포 및 온디바이스 추론
- 온디바이스 전처리: 센서 입력 데이터를 디바이스 내 DSP(디지털 신호 처리)나 필터링을 통해 전처리합니다.
- INT8 모델 추론: 경량화된 INT8 모델을 사용하여 실시간으로 추론을 수행합니다.
- 로컬 액션 및 클라우드 보완: 추론 결과의 신뢰도 임계값에 따라 로컬에서 즉각적인 액션을 수행하거나, 필요한 경우에만 클라우드로 데이터를 전송하여 보완적인 처리를 요청합니다.
5. OTA(Over-The-Air) 패키징 및 보안
- 안전한 펌웨어/모델 업데이트: OTA 업데이트 시 펌웨어 및 모델의 서명 및 무결성 검증 체계를 구축하여 보안 위협을 방지합니다.
6. 현장 추론 및 모니터링
- 지속적인 성능 검증: 배포된 모델의 현장 성능을 지속적으로 모니터링하고, 필요시 재학습 또는 미세 튜닝을 위한 데이터를 수집합니다.
로봇·스마트팩토리 TinyML 실전 적용 사례 및 체크포인트
TinyML은 로봇 및 스마트팩토리 분야에서 혁신적인 변화를 가져올 수 있습니다. 다음은 실제 적용 시나리오와 현직 엔지니어가 고려해야 할 체크포인트입니다.
스마트 제조 (예측 유지보수)
- 초저전력 센서 지능화: 모터 및 설비에 초저전력 진동·오디오 센서를 직접 부착하고, TinyML 모델을 통해 모터 주파수를 상시 분석합니다.
- 밀리초 단위 이상 감지: 이상 징후(고장 전조)를 밀리초 단위로 로컬에서 감지하여 가동 중단(Downtime)을 사전에 예방합니다. 이는 클라우드 기반 시스템으로는 달성하기 어려운 실시간 대응 능력을 제공합니다.
스마트미터 및 웨어러블 헬스케어
- 스트리밍 데이터 처리: 1D CNN/오토인코더 기반의 스트리밍 윈도우 처리 방식을 적용하여 실시간으로 데이터를 분석합니다.
- 개념 드리프트(Concept Drift) 대응: 현장 환경 변화로 인한 모델 성능 저하(개념 드리프트) 감지 시, 주기적인 미세 튜닝 파이프라인을 통해 모델을 최신 상태로 유지합니다.
현직 엔지니어 체크포인트
- 하드웨어 제약 확인: 대상 디바이스의 SRAM 및 Flash 용량(예: 수백 KB 수준)을 정확히 파악하고, 모델 크기가 이를 초과하지 않도록 설계합니다.
- MPU vs MCU/NPU 선택: 고성능 비전 멀티모달 처리에는 NPU/MPU(마이크로프로세서)를, 단순 센서 이벤트 감지에는 초저전력 MCU(MLC/ISPU 내장 센서 활용)를 사용하여 역할 분담을 명확히 합니다.
- 보안 및 OTA: 펌웨어 및 모델 업데이트 시 서명·무결성 검증 체계를 구축하여 보안 취약점을 최소화합니다.
TinyML 도입 시 흔한 실패 원인과 실무 방어 전략
TinyML은 강력한 기술이지만, 도입 과정에서 예상치 못한 문제에 직면할 수 있습니다. 다음은 주요 실패 가능성과 이에 대한 실무적인 대책입니다.
1. 정확도 저하 (Accuracy Drop)
무리한 양자화 및 프루닝으로 인해 모델의 엣지 추론 정확도가 급감하는 현상입니다.
- 대책: 캘리브레이션 데이터셋을 정밀하게 조정하고, 하이브리드 양자화(일부 레이어는 FP32 유지)를 적용하여 정확도 손실을 최소화합니다. 양자화 인식 학습(Quantization-aware Training)을 통해 학습 단계부터 양자화의 영향을 반영하는 것도 효과적입니다.
2. 하드웨어 제약 초과 (Out of Memory)
예상보다 큰 모델 크기로 인해 런타임 시 메모리 부족(Out of Memory)이 발생하는 문제입니다.
- 대책: 빌드 단계에서 메모리 맵핑을 철저히 검증하고, 모델 크기 및 런타임 메모리 사용량을 예측하는 도구를 적극 활용합니다. 불필요한 라이브러리나 기능은 제거하여 메모리 공간을 확보합니다.
3. 현장 환경 변이 (Concept Drift)
현장 노이즈나 환경 변화로 인해 모델의 오탐지율이 증가하는 현상입니다.
- 대책: 로컬 로깅 기능을 구현하여 현장 데이터를 주기적으로 수집하고, 이를 기반으로 경량 모델을 미세 튜닝하는 파이프라인을 마련합니다. 전이 학습(Transfer Learning) 기법을 활용하여 적은 데이터로도 모델을 빠르게 적응시킬 수 있습니다.
결론: 엣지·센서 지능화로 나아가는 엔지니어를 위한 제언
2026년, 임베디드 AI의 미래는 클라우드 중심 사고에서 벗어나 엣지 및 센서 지능화로의 전환에 달려 있습니다. TinyML은 이러한 전환의 핵심 동력이며, 현직 엔지니어 여러분이 직면한 ‘배포 지옥’을 탈출하고 혁신적인 솔루션을 구현할 수 있는 강력한 도구입니다.
지금 당장 무엇부터 시작해야 할까요? 먼저, 여러분의 프로젝트에서 가장 시급한 클라우드 의존성 문제와 전력 소모 문제를 파악하십시오. 그리고 대상 디바이스의 하드웨어 제약을 명확히 이해한 후, TensorFlow Lite Micro나 ExecuTorch와 같은 TinyML 프레임워크를 활용하여 작은 규모의 PoC(개념 증명)부터 시작해 보십시오. 초기에는 정확도 손실이나 메모리 제약에 부딪힐 수 있지만, 이 글에서 제시된 경량화 기법과 실무 방어 전략을 적용한다면 충분히 극복할 수 있습니다.
TinyML은 단순한 기술 트렌드를 넘어, 임베디드 시스템의 새로운 가능성을 열어줄 실용적인 해법입니다. 이 가이드가 여러분의 현업에 실질적인 도움이 되기를 바랍니다.
함께 보면 좋은 글
참고자료
최신 정보와 수치 확인에 참고한 공개 자료입니다. 제품·정책·가격은 변경될 수 있으므로 중요한 결정 전 원문도 확인해 주세요.
- datamintelligence.com
- nextmsc.com
- rootsanalysis.com
- redeweb.com
- ultralytics.com
- mdpi.com
- tistory.com
- tistory.com
- e4ds.com
- sandeepkumarchaudhary.com
작성 안내: 공개 자료 조사와 AI 보조 작성·자동 품질검사를 활용했습니다. 확인 가능한 출처를 우선 사용하며, 실제 환경에서는 버전·조건에 따라 결과가 달라질 수 있습니다.