감사 시즌의 악몽, 왜 IT 자산 대장은 늘 틀릴까요?
매년 연말연시나 보안/회계 감사 시즌만 되면 IT 담당자들의 식은땀은 마를 새가 없습니다. “이 서버는 누구 거죠?”, “이 클라우드 계정은 아직도 비용이 나가나요?”, “퇴사자 사내 계정이 왜 아직도 SaaS에 남아있죠?” 같은 질문에 진땀을 흘리는 것이 현실입니다.
문제의 본질은 명확합니다. 사내 물리 서버, 네트워크 장비 같은 온프레미스 자산부터 AWS, Azure, GCP 같은 퍼블릭 클라우드 인프라, 그리고 Microsoft 365, Google Workspace, Slack, Jira 등 임직원이 사용하는 수많은 SaaS 서비스까지, 기업의 IT 자산은 너무나도 분산되어 있습니다. 이 모든 정보를 수작업으로 엑셀에 통합하는 것은 비효율을 넘어 휴먼 에러와 부서 간 자산 불일치 문제를 야기하는 주범이 됩니다.
하지만 더 이상 야근과 불안에 시달릴 필요는 없습니다. 이 글에서는 파이썬을 활용해 각 영역의 데이터를 API와 스크립트로 10분 만에 긁어모으고, 교차 검증(Reconciliation)을 통해 불일치 항목만 핀셋으로 도려내는 자동화 파이프라인 구축 방법을 안내합니다. Core Briefman과 함께 IT 자산 관리의 새로운 표준을 만들어 보세요.
파이썬 기반 통합 IT 자산 대장, 어떻게 설계할까요?
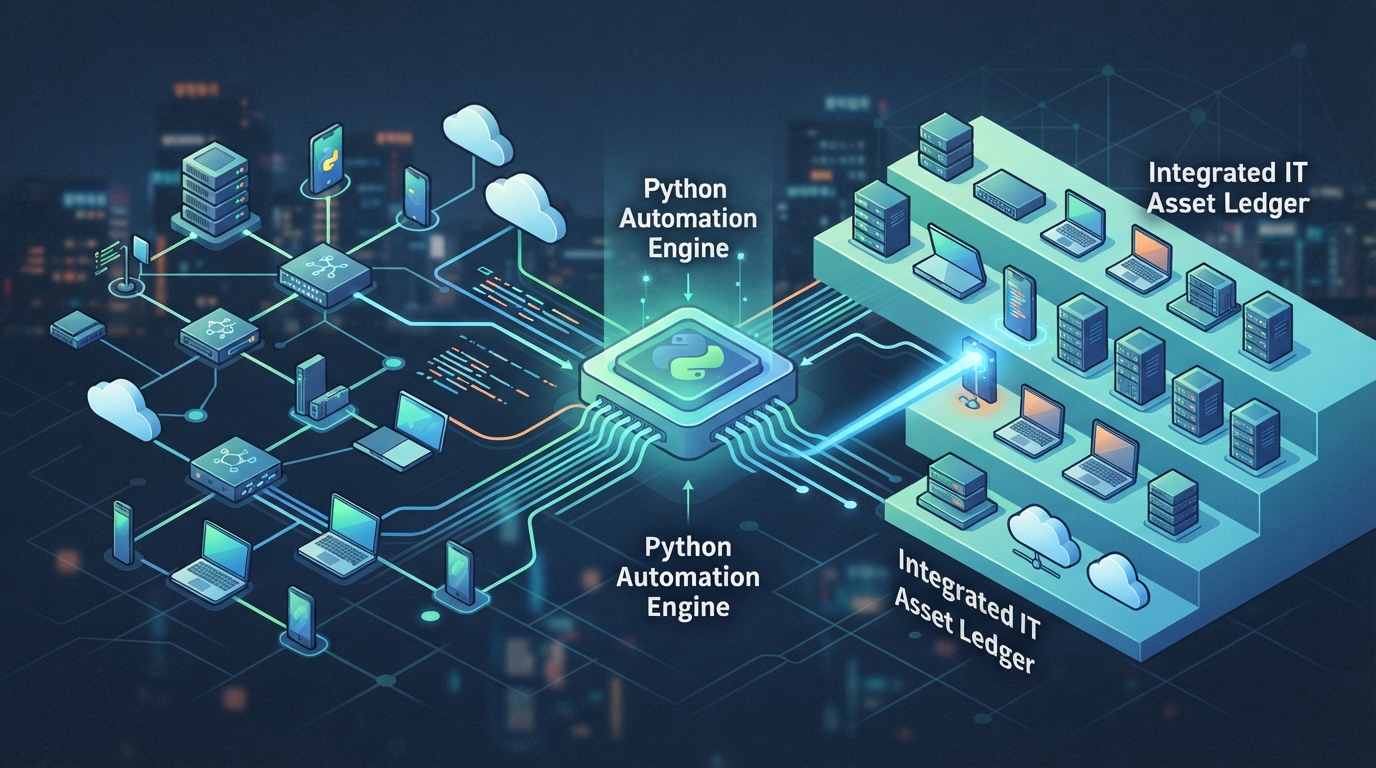
온프레미스, 클라우드, SaaS에 흩어진 자산 정보를 효과적으로 통합하고 관리하기 위한 파이썬 기반 아키텍처는 다음과 같은 단계로 구성됩니다.
1. Collector Layer: 원천 데이터 수집
- 온프레미스: SNMP 프로토콜(
pysnmp) 또는 사내 CMDB/Active Directory(LDAP,ldap3) 연동. 간이 IP 스캔(scapy,nmap)으로 생존 서버 파악. - 클라우드 (AWS, Azure, GCP): 각 클라우드 벤더의 공식 SDK(AWS
boto3, Azureazure-mgmt-*, GCPgoogle-cloud-*)를 활용하여 EC2/Compute Engine, RDS/Cloud SQL, S3/Cloud Storage 등 핵심 자산 정보 수집. - SaaS 및 엔터프라이즈 계정: Microsoft Graph API, Google Admin SDK 등 각 서비스의 REST API(
requests라이브러리)를 통해 활성 사용자 계정, 라이선스 현황 등 수집.
2. Normalizer Layer: 데이터 표준화
- 수집된 원천 데이터는 각기 다른 형식과 스키마를 가집니다. 이를
Asset ID,Asset Type,Owner,Environment,Status등 표준화된 스키마로 정규화하여 통합 관리의 기반을 마련합니다.
3. Reconciliation Engine: 불일치 교차 검증
- 정규화된 데이터를 기반으로 자산 간의 대조 및 검증을 수행합니다. 예를 들어, 클라우드 인스턴스의 ‘Owner’ 태그 정보와 사내 인사/SaaS 계정 정보를 대조하거나, 미사용 자산을 탐지하는 로직을 구현합니다.
4. Output Layer: 리포트 자동 생성
- 통합된 자산 정보와 불일치 내역을
pandas라이브러리를 활용하여 엑셀 파일로 자동 생성하거나, 대시보드 리포트 형태로 시각화하여 제공합니다.
10분 만에 끝내는 멀티 소스 자산 수집 파이썬 예제
통합 IT 자산 대장을 구축하기 위한 핵심은 각 소스에서 데이터를 효율적으로 수집하는 것입니다. 여기서는 boto3와 pandas, requests 라이브러리를 활용한 개념적인 파이썬 코드 스니펫을 소개합니다.
Step 1: AWS 자산(EC2) 수집기 작성
boto3를 사용하여 AWS EC2 인스턴스 정보를 수집하는 예시입니다. 다른 클라우드 자산(RDS, S3 등)이나 Azure, GCP 자산도 유사한 방식으로 각 SDK를 활용하여 수집할 수 있습니다.
import boto3
import pandas as pd

def collect_aws_ec2_assets():
    ec2 = boto3.client('ec2', region_name='ap-northeast-2')
    response = ec2.describe_instances()

    assets = []
    for reservation in response['Reservations']:
        for instance in reservation['Instances']:
            instance_id = instance['InstanceId']
            state = instance['State']['Name']
            name_tag = next((tag['Value'] for tag in instance.get('Tags', []) if tag['Key'] == 'Name'), 'Unnamed')
            owner_tag = next((tag['Value'] for tag in instance.get('Tags', []) if tag['Key'] == 'Owner'), 'Unknown')

            assets.append({
                'Source': 'AWS',
                'Asset_ID': instance_id,
                'Asset_Name': name_tag,
                'Asset_Type': 'EC2 Instance',
                'Status': state,
                'Owner': owner_tag,
                'Environment': 'Cloud'
            })
    return pd.DataFrame(assets)

if __name__ == "__main__":
    df_aws_ec2 = collect_aws_ec2_assets()
    print("AWS EC2 자산 수집 완료:")
    print(df_aws_ec2.head())
Step 2: SaaS 자산(예: Google Workspace 사용자) 수집 (개념적)
requests 라이브러리를 활용하여 Google Admin SDK와 같은 SaaS API를 호출하여 사용자 정보를 수집하는 개념적인 예시입니다. 실제 구현 시에는 OAuth 2.0 인증 과정이 필요합니다.
import requests
import pandas as pd

def collect_google_workspace_users(access_token):
    headers = {'Authorization': f'Bearer {access_token}'}
    url = 'https://admin.googleapis.com/admin/directory/v1/users'

    response = requests.get(url, headers=headers)
    response.raise_for_status() # HTTP 에러 발생 시 예외 처리

    users = []
    for user in response.json().get('users', []):
        users.append({
            'Source': 'Google Workspace',
            'Asset_ID': user['id'],
            'Asset_Name': user['primaryEmail'],
            'Asset_Type': 'User Account',
            'Status': 'Active' if not user.get('suspended') else 'Suspended',
            'Owner': user['primaryEmail'], # 사용자 자체가 소유자
            'Environment': 'SaaS'
        })
    return pd.DataFrame(users)

# 실제 실행 시 access_token을 얻는 로직이 필요합니다.
# if __name__ == "__main__":
#     # access_token = get_google_workspace_access_token()
#     # df_gws_users = collect_google_workspace_users(access_token)
#     # print("Google Workspace 사용자 수집 완료:")
#     # print(df_gws_users.head())
Step 3: 데이터 통합 및 초기 대장 생성
수집된 각 데이터프레임을 pd.concat()을 사용하여 하나의 통합 데이터프레임으로 병합합니다. 이 통합 데이터프레임이 바로 ‘통합 IT 자산 대장’의 뼈대가 됩니다.
# 모든 자산 데이터프레임을 통합 (예시)
# df_onprem = collect_onprem_assets() # 온프레미스 수집 함수
# df_azure = collect_azure_assets()   # Azure 수집 함수
# df_gcp = collect_gcp_assets()     # GCP 수집 함수
# df_ms365 = collect_ms365_assets()   # MS 365 수집 함수

# all_assets_df = pd.concat([df_aws_ec2, df_gws_users, df_onprem, df_azure, df_gcp, df_ms365], ignore_index=True)
# print("통합 IT 자산 대장 초기 생성 완료:")
# print(all_assets_df.head())
하이라이트: ‘불일치 핀셋 탐지’ 로직 구현 방법
단순한 자산 수집을 넘어, 파이썬의 강력한 데이터 처리 능력은 숨겨진 불일치를 ‘핀셋’처럼 찾아내는 데 빛을 발합니다. 무엇을, 어떻게 탐지할 수 있을까요?
무엇을 탐지하는가?
- 고아 자산(Orphaned Asset): 클라우드에 존재하지만 담당자(Owner 태그)가 없거나, 퇴사자 명의로 되어 있어 방치된 자산.
- 미등록 온프레미스/클라우드 불일치: 공식 예산안이나 기존 대장에는 없는데, API를 통해 실제 환경에서 탐지된 숨겨진 자산. (일명 ‘쉐도우 IT’)
- 비용 낭비 유발 자산: 정지 상태이나 불필요한 볼륨/IP가 물려있어 계속 비용이 발생하는 ‘좀비 자산’.
- SaaS 계정 불일치: 퇴사자 계정이 SaaS에 여전히 활성 상태로 남아있거나, 라이선스가 과도하게 할당된 경우.
핀셋 탐지 구현: Pandas의 merge 활용
pandas의 merge(how='outer', indicator=True) 기능을 활용하면 두 데이터셋 간의 차이를 명확하게 파악할 수 있습니다. 예를 들어, ‘승인된 자산 목록’ 데이터프레임과 ‘실제 환경에서 수집된 자산’ 데이터프레임을 비교하여 불일치를 찾아냅니다.
import pandas as pd

# 예시 데이터프레임 생성
# 실제 환경에서 수집된 자산 (위의 collect_aws_ec2_assets 결과 등)
actual_assets = pd.DataFrame([
    {'Asset_ID': 'i-001', 'Name': 'Web Server 1', 'Owner': 'Alice'},
    {'Asset_ID': 'i-002', 'Name': 'DB Server 1', 'Owner': 'Bob'},
    {'Asset_ID': 'i-003', 'Name': 'Dev Server', 'Owner': 'Charlie'},
    {'Asset_ID': 'i-005', 'Name': 'Unknown Server', 'Owner': 'Unknown'} # 실제 환경에만 있는 자산
])

# 승인된 자산 대장 (CMDB 또는 수동 관리 엑셀)
approved_assets = pd.DataFrame([
    {'Asset_ID': 'i-001', 'Name': 'Web Server 1', 'Owner': 'Alice'},
    {'Asset_ID': 'i-002', 'Name': 'DB Server 1', 'Owner': 'Bob'},
    {'Asset_ID': 'i-004', 'Name': 'Test Server', 'Owner': 'David'} # 대장에만 있는 자산
])

# 두 데이터프레임을 'Asset_ID' 기준으로 외부 조인(outer merge)하고, 출처를 표시
discrepancies = pd.merge(actual_assets, approved_assets, on='Asset_ID', how='outer', indicator=True, suffixes=('_actual', '_approved'))

# 실제 환경에만 존재하는 자산 (고아 자산 또는 미등록 자산)
only_in_actual = discrepancies[discrepancies['_merge'] == 'left_only']
print("\n실제 환경에만 존재하는 자산 (미등록/고아):")
print(only_in_actual[['Asset_ID', 'Name_actual', 'Owner_actual']])

# 승인된 대장에만 존재하는 자산 (삭제되었으나 대장에 남은 자산)
only_in_approved = discrepancies[discrepancies['_merge'] == 'right_only']
print("\n승인된 대장에만 존재하는 자산 (삭제되었으나 대장에 남음):")
print(only_in_approved[['Asset_ID', 'Name_approved', 'Owner_approved']])

# 양쪽에 모두 존재하지만 내용이 다른 자산 (예: Owner 불일치 등 추가 로직 필요)
# both_present = discrepancies[discrepancies['_merge'] == 'both']
# print("\n양쪽에 모두 존재하는 자산 (추가 검증 필요):")
# print(both_present.head())
위 코드에서 _merge 컬럼은 각 행이 어느 데이터프레임에만 존재하는지(`left_only`, `right_only`) 또는 양쪽에 모두 존재하는지(`both`)를 알려줍니다. 이를 통해 ‘실제 환경에는 있으나 대장에 누락된 항목’과 ‘대장에는 있으나 실제 환경에는 없는 항목’을 완벽하게 분리 추출하여 핀셋 탐지가 가능해집니다.
실무 적용 시 체크포인트 및 실패 방지 가이드
파이썬 기반 IT 자산 자동화는 강력하지만, 실무에 적용할 때는 몇 가지 주의사항을 고려해야 합니다.
1. 권한(IAM) 최소 원칙(Least Privilege) 준수
자산 정보를 조회하기 위해 AWS IAM User/Role, Azure Service Principal, GCP Service Account 등에 권한을 부여할 때는 반드시 Read-Only(읽기 전용) 권한만 부여해야 합니다. 잘못된 권한 설정은 심각한 보안 사고로 이어질 수 있습니다. 필요한 리소스에 대한 조회 권한만 최소한으로 허용하는 것이 중요합니다.
2. API Rate Limit 대응
자산이 수천 개 이상인 대기업 환경에서는 클라우드 벤더나 SaaS 제공업체의 API 호출 제한(Throttling)에 걸릴 수 있습니다. 이를 방지하기 위해 스크립트에 재시도(Retry) 로직과 예외 처리(try-except)를 반드시 포함해야 합니다. 예를 들어, 특정 API 호출이 실패하면 잠시 대기 후 다시 시도하는 로직을 구현할 수 있습니다.
3. 주기적 자동화 및 알림 시스템 구축
이 스크립트를 로컬에서 수동으로 실행하는 것에 그치지 않고, 사내 깃허브 액션(GitHub Actions), Jenkins, 또는 사내 서버의 Cron 작업을 통해 주기적으로 자동 실행되도록 고도화하세요. 매주 월요일 아침, 통합 자산 리포트와 불일치 내역이 Slack이나 이메일로 자동 발송되도록 설정하면, IT 자산 관리의 효율성을 극대화할 수 있습니다.
이제, 감사 시즌을 두려워하지 마세요
파이썬 기반의 통합 IT 자산 대장 자동화는 단순히 보고서 하나를 만드는 것을 넘어섭니다. 이는 매년 감사 시즌마다 소모되던 수십 시간의 야근을 단 10분 내외의 스크립트 실행으로 줄여주는 실질적인 시간 및 인건비 절감 구조를 제공합니다. 나아가, 숨겨진 자산으로 인한 과태료나 보안 감사 지적 리스크를 사전에 차단하여 기업의 컴플라이언스 수준을 한 단계 끌어올리는 효과도 가져옵니다.
복잡하고 파편화된 IT 환경 속에서 더 이상 수작업의 굴레에 갇히지 마세요. 지금 바로 파이썬 스크립트 구축을 시작하여 IT 자산 관리의 새로운 표준을 만들고, 감사 시즌을 자신감 있게 맞이하시길 바랍니다.
함께 보면 좋은 글
- 2026년, ‘버려진 내부 스크립트’에 발목 잡히지 마세요! 파이썬으로 팀 내 ‘유틸리티 코드베이스’ 10분 만에 자동 감사 & 활용도 리포트 생성!
- 2026년 감사 시즌 악몽 탈출! 파이썬으로 ‘개인정보 접근 로그’ 자동 수집 & 규제 준수 보고서 10분 만에 끝내기
- 2026년, ‘신입사원 온보딩 지옥’ 아직도 수동으로? 파이썬으로 IT-HR 통합 프로세스 10분 만에 자동화하고 이탈률 절반 줄이기!
참고자료
최신 정보와 수치 확인에 참고한 공개 자료입니다. 제품·정책·가격은 변경될 수 있으므로 중요한 결정 전 원문도 확인해 주세요.
작성 안내: 공개 자료 조사와 AI 보조 작성·자동 품질검사를 활용했습니다. 확인 가능한 출처를 우선 사용하며, 실제 환경에서는 버전·조건에 따라 결과가 달라질 수 있습니다.