왜 MCP v2인가요? 기존 v1의 한계와 v2의 등장 배경
AI 에이전트와 외부 서비스 간의 표준 인터페이스인 모델 컨텍스트 프로토콜(MCP)은 개발자들에게 강력한 도구로 자리매김했습니다. 하지만 초기 MCP v1은 로컬 환경 중심의 설계에서 출발하여, 원격 웹 인프라로 확장되는 과정에서 몇 가지 한계에 부딪혔습니다. 특히 프로토콜 수준에서 세션 및 상태 유지를 강제하는 구조는 대규모 서비스 환경에서 병목 현상을 유발했습니다.
MCP v1은 클라이언트와 서버 간 ‘Sticky Session(고정 세션)’이나 Redis 같은 별도의 세션 스토어 연동을 필수적으로 요구했습니다. 이는 로드 밸런싱 환경에서 서버의 수평 확장(Horizontal Scaling)을 어렵게 만드는 주요 원인이었습니다. 서버가 특정 클라이언트의 이전 연결 상태를 기억해야 했기 때문에, 요청이 여러 서버로 분산될 경우 문제가 발생할 수 있었죠.
2026년 7월 주요 개정된 MCP v2 스펙은 이러한 한계를 극복하기 위해 프로토콜 수준의 세션을 완전히 제거하고 스테이트리스(Stateless) 구조로 전환되었습니다. 이제 모든 요청은 프로토콜 버전 및 필요한 메타데이터 정보를 각 요청 내에 자체적으로 포함합니다. 서버는 특정 클라이언트의 이전 상태에 의존하지 않고, 독립된 개별 요청 단위로 처리할 수 있게 되어 표준 라운드 로빈 로드 밸런서 뒤에 백엔드 워커를 자유롭게 배치하여 수평 확장이 가능해졌습니다.
MCP v2의 핵심 기술 변화: 스테이트리스 프로토콜의 작동 원리
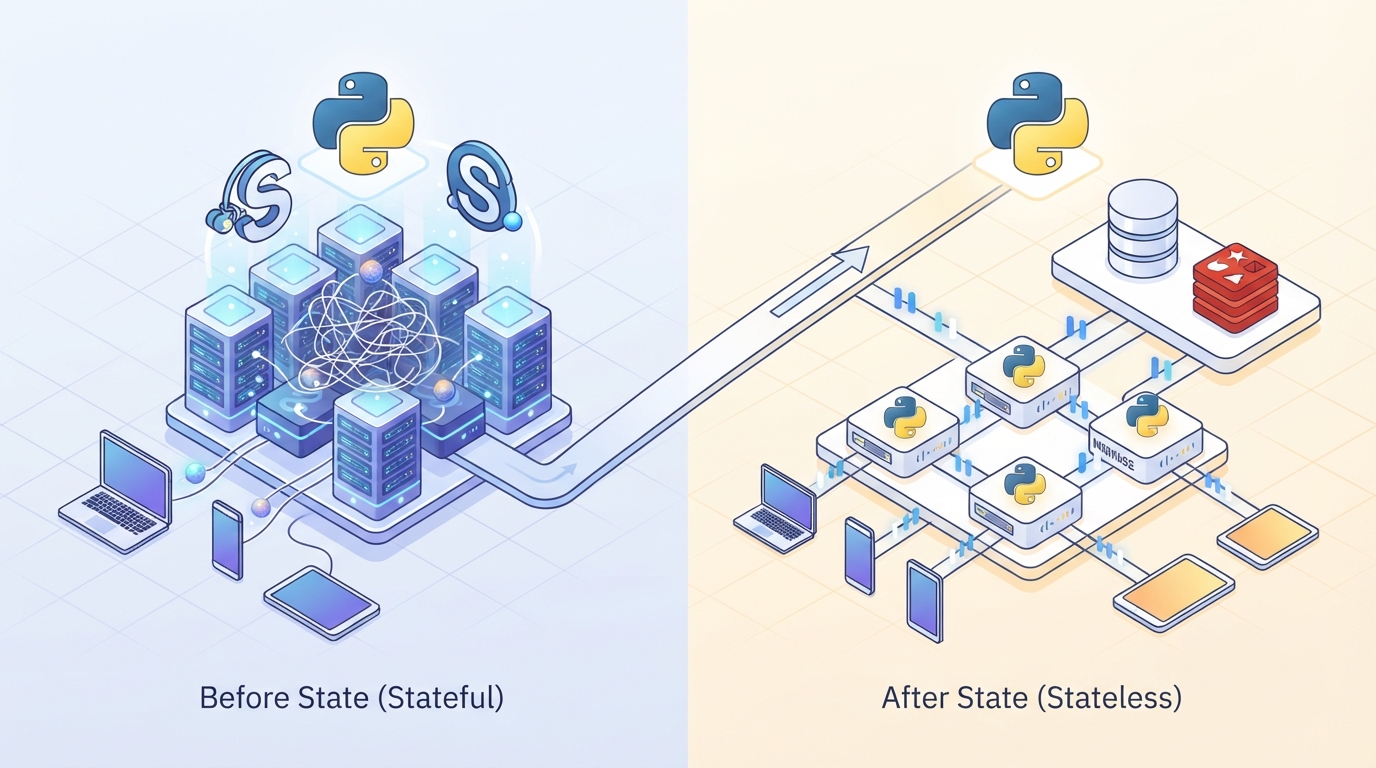
MCP v2는 프로토콜 자체를 스테이트리스하게 만듦으로써 백엔드 설계의 복잡성을 줄이고 확장성을 극대화했습니다. 다음은 주요 기술적 변화 포인트입니다.
프로토콜 메타데이터와 자체 완결형 요청 모델
_meta필드 활용: 클라이언트는 매 요청 시 프로토콜 버전 및 관련 Capabilities 정보를_meta필드에 담아 전송합니다. 서버는 이 정보를 바탕으로 별도의 세션 상태 조회 없이 즉각 응답을 생성할 수 있습니다. 이는 각 요청이 필요한 모든 정보를 스스로 담고 있는 ‘자체 완결형(Self-contained)’ 요청 모델을 가능하게 합니다.- 디스커버리 요청 (
server/discover): 서버는 자신이 지원하는 프로토콜 버전과 기능(Capabilities)을 클라이언트에게 광고할 수 있습니다. 클라이언트는 본격적인 상호작용 전에 이 디스커버리 요청을 통해 서버의 역량을 확인하고 적절히 대응할 수 있습니다.
Python SDK v2: 설치부터 마이그레이션 주의사항까지
MCP v2의 강력한 기능을 Python 환경에서 활용하려면 Python SDK v2를 사용해야 합니다. 기존 v1.x 버전과 호환되지 않는 브레이킹 체인지가 있으므로, 마이그레이션 시 주의가 필요합니다.
지원 버전 및 설치
Python SDK v2는 Python 3.10 이상을 공식 지원합니다. 설치는 다음과 같이 간단합니다.
uv add "mcp[cli]"
# 또는
pip install "mcp[cli]"
마이그레이션 주의사항
기존 MCP v1.x 버전을 사용하던 프로젝트라면 마이그레이션에 충분한 시간을 할애해야 합니다. v2는 API 시그니처 및 내부 동작 방식에 다수의 변경 사항을 포함하고 있어 하위 호환성이 깨집니다. 기존 프로젝트를 마이그레이션하기 전까지는 mcp>=1.28,<2와 같이 상한선 버전을 명시하여 의도치 않은 업데이트를 방지하는 것이 좋습니다. 공식 마이그레이션 가이드(https://py.sdk.modelcontextprotocol.io/)를 반드시 참조하여 단계적으로 전환하시길 권장합니다.
실전 Python 백엔드 설계 가이드: 스테이트리스 아키텍처 구축
MCP v2 기반의 Python 백엔드를 설계할 때는 스테이트리스 패러다임을 최대한 활용하여 확장성과 안정성을 확보해야 합니다.
트랜스포트 계층 선택 전략
MCP v2는 다양한 통신 방식을 지원하므로, 백엔드 아키텍처와 서비스 요구사항에 맞춰 적절한 트랜스포트 계층을 선택하는 것이 중요합니다.
| 트랜스포트 종류 | 주요 용도 및 특징 | 권장 아키텍처 환경 |
|---|---|---|
| STDIO | 프로세스 표준 입출력을 활용하는 방식. 설정이 가장 단순함 | 로컬 개발 환경, 데스크톱 앱 연동 (예: Claude Desktop) |
| Streamable HTTP | HTTP 스트리밍 기반 트랜스포트 | 대규모 클라우드 분산 백엔드, 웹 서버 연동 |
| SSE (Server-Sent Events) | 실시간 단방향/양방향 이벤트 스트리밍 | 이벤트 기반 알림 및 점진적 응답 구조 |
스테이트리스 백엔드 구현 체크리스트
- 세션 종속성 제거: 메모리 내 전역 변수나 로컬 캐시에 특정 클라이언트의 세션 정보를 저장하는 패턴을 전면 배제해야 합니다. 모든 요청은 자급자족형(Self-contained) 데이터 구조를 갖추도록 설계하여, 어떤 서버 인스턴스에서도 독립적으로 처리될 수 있도록 합니다.
- 비동기(
async/await) 패턴 적용: Python SDK v2는 코어 레벨에서 고성능 비동기 처리를 전제로 설계되었습니다. 데이터베이스 조회, 외부 API 호출 등 I/O 바운드 작업은 반드시async함수로 구현하여 이벤트 루프 블로킹을 방지하고 서버의 응답성을 높여야 합니다. - 로드 밸런싱 및 분산 배포 구성: MCP v2는 세션 스티키니스(Sticky Session) 설정이 불필요합니다. 따라서 인프라 단에서 표준 라운드 로빈 로드 밸런서를 구성하여 다수의 Python 백엔드 워커 프로세스로 부하를 효율적으로 분산할 수 있습니다. 이는 서비스의 가용성과 확장성을 크게 향상시킵니다.
MCP v2 Python 서버, 이렇게 구현하세요 (코드 예시)
Python SDK v2를 활용한 기본적인 MCP 서버의 셋업 예시입니다. 이 코드는 툴 목록을 제공하고, 특정 툴 호출을 처리하는 스테이트리스 백엔드의 핵심 구조를 보여줍니다.
from mcp.server import Server
from mcp.types import Tool, TextContent
import asyncio

# 서버 인스턴스 초기화
app = Server("stateless-mcp-backend")

@app.list_tools()
async def handle_list_tools() -> list[Tool]:
    """서버가 제공하는 툴 목록을 반환 (스테이트리스하게 동작)"""
    return [
        Tool(
            name="calculate_sum",
            description="두 숫자의 합을 계산합니다.",
            inputSchema={
                "type": "object",
                "properties": {
                    "a": {"type": "number"},
                    "b": {"type": "number"}
                },
                "required": ["a", "b"]
            }
        )
    ]

@app.call_tool()
async def handle_call_tool(name: str, arguments: dict) -> list[TextContent]:
    """툴 실행 요청 처리"""
    if name == "calculate_sum":
        result = arguments["a"] + arguments["b"]
        return [TextContent(type="text", text=f"결과: {result}")]
    raise ValueError(f"지원하지 않는 툴입니다: {name}")

# 실행 진입점 (STDIO 또는 HTTP 트랜스포트 연결)
if __name__ == "__main__":
    # 실제 프로덕션 환경에서는 알맞은 트랜스포트 어댑터와 연동
    # 예: app.run_stdio() 또는 Uvicorn과 연동
    pass
위 예시에서 handle_list_tools와 handle_call_tool 함수는 어떤 클라이언트의 이전 상태에도 의존하지 않고 독립적으로 동작합니다. async 키워드를 사용하여 비동기적으로 처리될 수 있도록 설계된 점도 주목할 만합니다.
성공적인 MCP v2 도입을 위한 리스크 관리 및 주의사항
MCP v2는 많은 이점을 제공하지만, 성공적인 도입을 위해서는 몇 가지 잠재적 리스크와 주의사항을 인지하고 관리해야 합니다.
- 브레이킹 체인지로 인한 마이그레이션 공수: v1에서 v2로 전환할 때 API 시그니처 및 내부 동작 방식에 다수의 변경 사항이 존재합니다. 기존 코드가 있는 경우, 충분한 테스트 기간과 단계적 브랜치 분리를 통해 안정적인 마이그레이션을 진행해야 합니다. 예상보다 많은 공수가 소요될 수 있음을 염두에 두세요.
- 외부 상태 저장소(DB 등) 설계 미흡: MCP v2 프로토콜 자체는 스테이트리스해졌지만, 비즈니스 로직 상 사용자의 대화 맥락, 권한 인증 상태, 영속적인 데이터 등을 관리해야 하는 경우가 많습니다. 이때는 백엔드 외부(예: Redis, PostgreSQL, DynamoDB 등)에 명시적인 영속화 계층을 설계해야 합니다. 프로토콜 레벨의 세션 유무와 비즈니스 레벨의 상태 관리를 혼동하지 않도록 주의해야 합니다. 스테이트리스 프로토콜은 서버 확장을 용이하게 할 뿐, 애플리케이션의 모든 상태를 없애는 것은 아닙니다.
이러한 주의사항을 충분히 고려하여 설계하고 구현한다면, MCP v2는 여러분의 Python 백엔드를 더욱 강력하고 확장성 있게 만들어 줄 것입니다.
결론: 지금 바로 MCP v2로 확장 가능한 백엔드를 구축하세요
MCP v2는 기존 v1의 한계를 극복하고, 현대적인 클라우드 환경에 최적화된 스테이트리스 프로토콜을 제공합니다. Python 개발자라면 이제 복잡한 세션 관리에 대한 부담 없이, async/await 기반의 고성능 백엔드를 설계하고 수평 확장을 통해 대규모 트래픽에도 유연하게 대응할 수 있습니다.
Core Briefman은 여러분이 MCP v2의 핵심 개념을 이해하고, 실제 Python 백엔드에 성공적으로 적용하여 더욱 견고하고 확장성 높은 서비스를 구축하는 데 이 가이드가 실질적인 도움이 되기를 바랍니다. 지금 바로 Python SDK v2를 설치하고, 스테이트리스 아키텍처의 이점을 경험해 보세요.
함께 보면 좋은 글
- 모델 컨텍스트 프로토콜(MCP) v2: 스테이트리스 전환과 Python 백엔드 설계 핵심 가이드
- MCP 2026 스테이트리스 전환: AI 에이전트 클라우드 배포와 마이그레이션 실전 가이드
참고자료
최신 정보와 수치 확인에 참고한 공개 자료입니다. 제품·정책·가격은 변경될 수 있으므로 중요한 결정 전 원문도 확인해 주세요.
작성 안내: 공개 자료 조사와 AI 보조 작성·자동 품질검사를 활용했습니다. 확인 가능한 출처를 우선 사용하며, 실제 환경에서는 버전·조건에 따라 결과가 달라질 수 있습니다.